


Stable Audio
Stability AI 的 AI 音乐与音效生成工具,文本描述即可生成完整配乐,支持音频修复与本地部署。
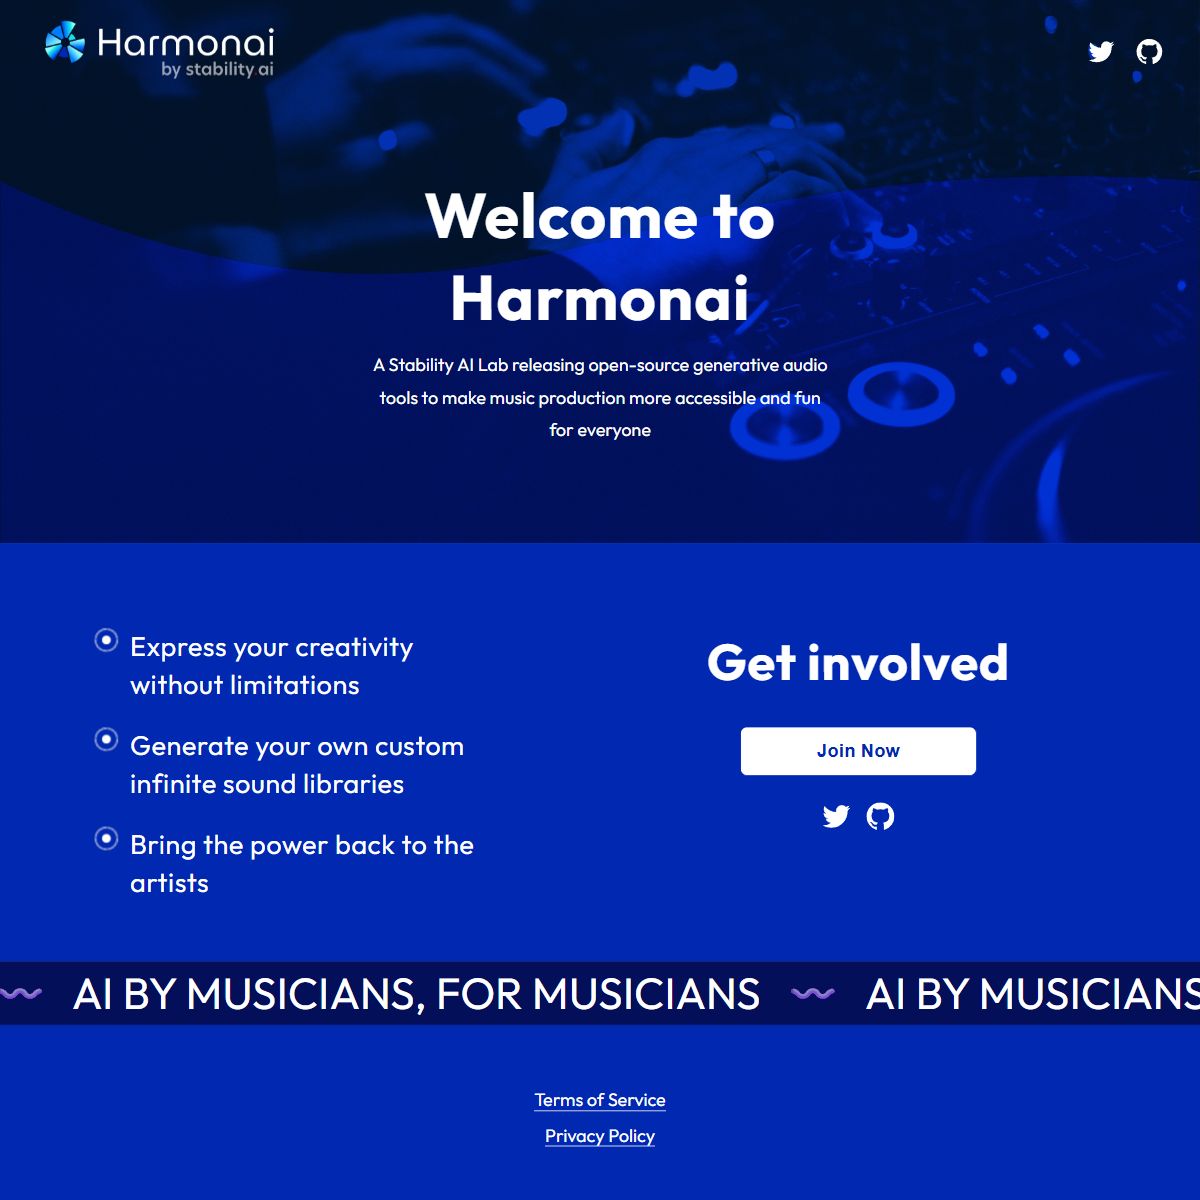
 Harmonai
 是由 Stability AI 支持的开源生成式音频研究实验室,核心理念是让音乐创作的工具掌握在创作者自己手里。Harmonai 不像商业化音乐平台那样直接输出完整歌曲,而是把扩散模型这样一套底层音频生成引擎开放出来,供音乐人、开发者和研究者自由取用与改造。
Harmonai 的旗舰项目 Dance Diffusion 直接在原始音频波形上做文章,能凭噪声生成一秒到几秒的高保真音色片段,也能在两段音频之间做插值、对已有素材做风格迁移。实际操作时,多数人通过 Hugging Face、Replicate 或 Google Colab 上的笔记本运行,想深度定制的就把代码拉到本地、喂入自己的素材去训练专属模型。
用下来最明显的感受是,Harmonai 给的是「素材引擎」而不是「写歌机器」。电子音乐人用 Harmonai 生成无限变化的鼓点填充、低频铺底,影视音效师靠 Harmonai 产出环境底噪和转场层,这些都是传统采样包给不了的灵活度。代价是门槛摆在那里:要会用 Python 或 Colab,生成结果多半是短片段,还得靠人去编排打磨,指望一键出歌会失望。
Harmonai 背后是一个规模可观的 Discord 社区,模型权重放 GitHub 上按 MIT 等协议开源,商用、改代码都不设卡。比较现实的限制是项目维护节奏跟着 Stability AI 的资源走,部分仓库更新已经慢下来,新手最好先拿社区教程和官方笔记本上手,等摸熟了再考虑本地部署和自训模型。
全部工具与模型权重以 MIT 等开源协议免费提供,代码、训练脚本与预训练权重均可从 GitHub、Hugging Face 自由下载,个人、教育、开发与商业用途都不设门槛。价格可能随官方调整。
站内不设付费档位,所有模型与代码均开源免费获取;旗舰扩散模型 Dance Diffusion 以开源权重形式在 Hugging Face、Replicate 等平台提供(如 v0.10 版本),运行所需算力由用户自备本地 GPU 或云笔记本额度承担,官方不收取任何订阅或按量费用。
| 对比维度 | Harmonai(本工具) | Suno | Udio | Stable Audio | AIVA |
|---|---|---|---|---|---|
| 定位 | 开源生成式音频研究实验室,把扩散模型引擎开放给创作者自取自用。 | 面向普通用户的闭源商用音乐生成平台,输入文字描述即可产出带人声的完整歌曲。 | 闭源 AI 音乐生成服务,主打高质感流行与多种曲风的一键成曲。 | Stability AI 推出的商用文本生成音乐产品,与 Harmonai 同门但走闭源服务路线。 | 老牌 AI 作曲工具,偏古典与配乐场景,输出可编辑的乐谱与工程文件。 |
| 核心优势 | 代码与权重完全开源,可本地部署、自训模型,生成素材无版权束缚。 | 上手极简,几句话就能出一首结构完整的歌,适合快速做 demo 和短视频配乐。 | 成曲听感接近商业发行,风格覆盖广,适合做成品向的音乐片段。 | 依托 Stability AI 资源,出歌质量稳定,交互比开源项目顺手。 | 生成结果带可编辑乐谱,适合影视游戏配乐的专业工作流。 |
| 主要短板 | 偏底层引擎,需会 Python 或 Colab,输出多为短片段,需人工编排。 | 模型与曲库封闭,生成结果受平台限制,难做底层定制,商用授权也需看平台条款。 | 完全黑盒,无法自训模型或导出原始素材,定制空间小。 | 按次或订阅计费,模型不开放,自定义与本地部署都做不到。 | 创作自由度偏向既有曲式,实验性音色与无节制采样生成不是强项。 |
| 价格 | 全开源免费,不设付费档位,运行成本由用户自备硬件或云额度承担。 | 提供免费额度,进阶套餐按月订阅收费。 | 免费档有限额,付费按月订阅解锁更多生成次数。 | 提供免费试用,正式使用按月订阅。 | 有免费版,专业版按月订阅。 |
| 适合谁 | 要可控、无封锁、能改代码的音乐人、开发者与研究者。 | 想要一键出歌、不关心底层模型的 casual 创作者。 | 追求成品质量、不愿折腾工程细节的音乐爱好者。 | 想用 Stability AI 音频能力、但不想碰代码的用户。 | 需要结构化配乐与乐谱的影视、游戏作曲家。 |